
原生音频生成
增强了对话、环境音效及音频元素的处理能力,为所有编辑功能增加了音频生成,使输出的视频具备完整声音元素。
套餐最高可省 73%
Veo 3.1 是 Google DeepMind 推出的最新 AI 视频生成模型,将电影级控制与更高的视觉保真度相结合。该模型支持 1080p 和 4K 分辨率输出,提供原生音频生成、多图像参考和精细编辑功能,成为专业创作者的首选工具。
Veo 3.1
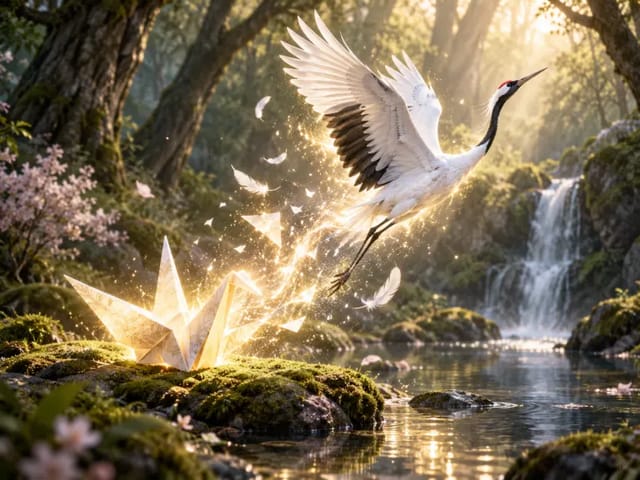
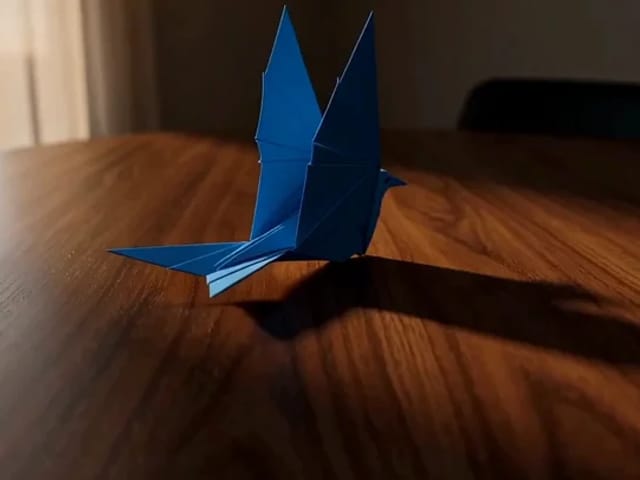
纸鹤起飞 · Veo 3.1 Fast
旧素材参考 · 实际生成模型:Veo 3.1 Fast。仅供参考,不作为当前所选模型的效果实测。
在前代基础上大幅升级,带来更强大的创作能力。
增强了对话、环境音效及音频元素的处理能力,为所有编辑功能增加了音频生成,使输出的视频具备完整声音元素。
支持 720p 与 1080p 分辨率输出,帧速率稳定在 24 帧/秒。通过延伸功能,基础视频最长可达 148 秒连续片段。
提供最多三张参考图片指导、首尾帧指定和视频延长功能,让用户对视频创作拥有电影级的精准控制。
复用自有素材库中由 Kling 2.6 与 Veo 3.1 Fast 生成的旧视频。每段素材均标注实际来源模型;它可能与当前所选模型不同,仅供构图与动作参考。
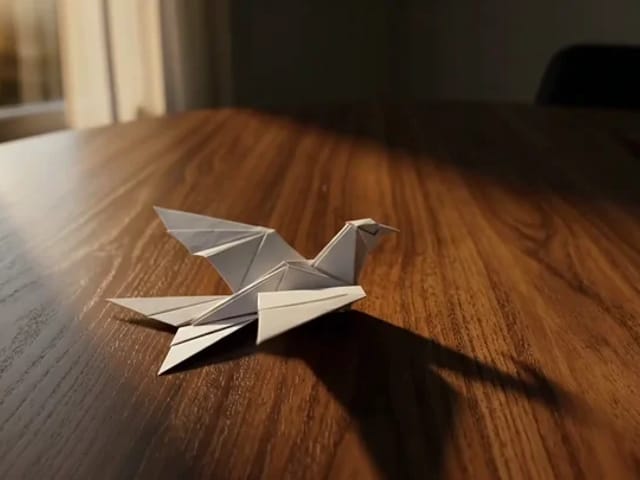
来源模型:Veo 3.1 Fast。暖光木桌上的纸鹤展开翅膀起飞。
来源模型:Veo 3.1 Fast。金毛犬在夕阳下的沙滩上移动。
来源模型:Kling 2.6。固定镜头下的青色陶瓷小鸟与轻轻移动的绿叶。
来源模型:Kling 2.6。由参考图制作的方形陶瓷小鸟与绿叶动画。
作为 Google DeepMind 最新研发成果,为专业创作者提供全方位的技术支持。
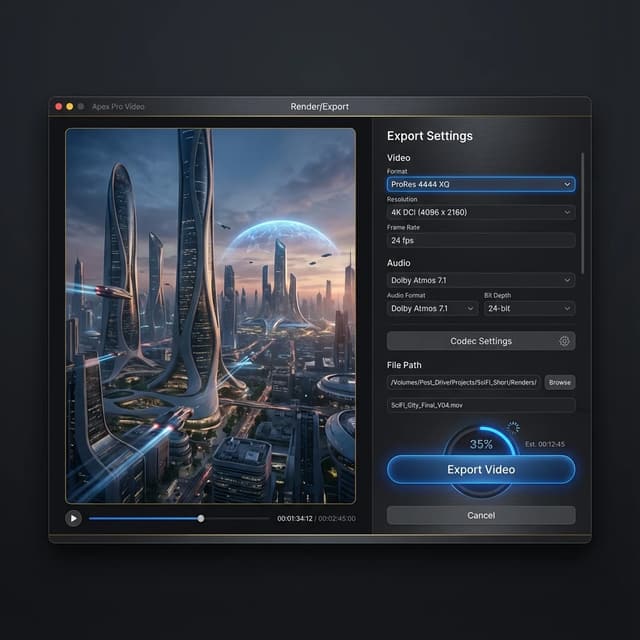
将电影级的控制能力与 AI 生成相结合。从关键帧指定到视频扩展,从多图像参考到音频编辑,为创作者提供了全方位的精准控制工具。
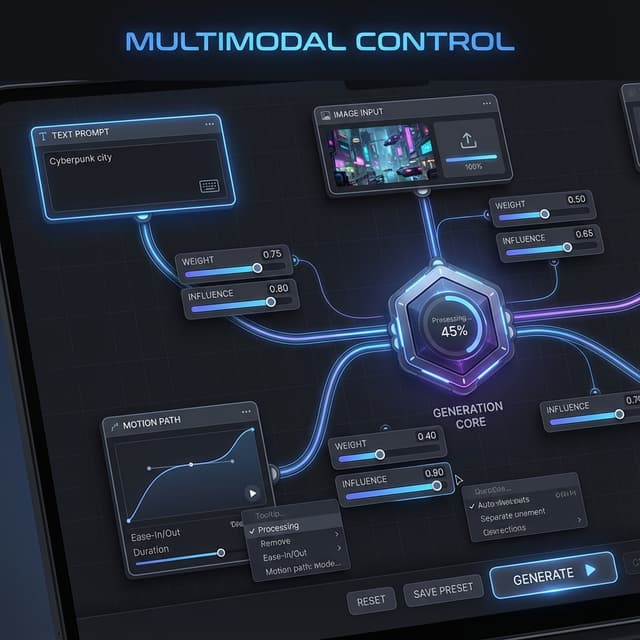
可生成高保真的 8 秒 720p、1080p 或 4K 视频。在处理现实世界物理定律方面表现出色,画面风格偏向电影质感,视觉效果更加精致,伪影更少、稳定性更高。
通过多个平台向用户开放,包括视频编辑器 Flow、Gemini 应用程序,以及面向开发者的 Vertex AI 和 Gemini API 接口,为各类用户提供灵活的访问方式。
来自全球创作者对功能和性能的真实反馈。
关于功能、性能和使用方式的详细解答。
是 Google DeepMind 推出的最新 AI 视频生成模型,主要升级包括:原生音频生成功能、支持最多三张图像参考、关键帧控制、视频扩展功能(最长 148 秒)、支持 720p/1080p/4K 分辨率输出,以及更强的提示词理解能力。
允许用户将先前生成的视频片段延长 7 秒,最多可延长 20 次,最终可生成长达 148 秒的连续视频片段。在扩展过程中能够保持完美的视觉连续性和内容一致性。
在前代基础上显著增强了音频处理能力,为所有编辑功能原生集成了音频生成。能够处理对话、环境音效及其他音频元素,使输出的视频片段具备完整的声音元素,实现高质量的音画同步。
允许用户指定视频的第一帧和最后一帧,模型会通过插值算法自动生成中间的过渡画面。这个功能非常适合创建无缝循环视频、流畅的变形效果或连接不同场景,让创作者对视频生成过程拥有精准控制。
支持 720p 与 1080p 分辨率输出,帧速率稳定在 24 帧/秒。还可生成高保真的 4K 视频,基础视频生成长度提供 4 秒、6 秒或 8 秒选项。
通过多个平台向用户开放,包括视频编辑器 Flow、Gemini 应用程序,以及面向开发者的 Vertex AI 和 Gemini API 接口。Google 正在逐步集成到更多平台中,为不同类型的用户提供灵活的访问方式。
Google DeepMind 最新的 AI 视频生成模型现已开放使用。体验电影级的视频创作控制、原生音频生成和高保真视觉输出,成为您专业视频创作的得力助手。
HeyGen Video 1 将文字或一张首帧图片变成带声音的 5–15 秒视频。选择 480p 或 768p,在 NanoPic 制作产品演示、广告短片和图片动画。
打开工具


在 NanoPic 使用 OmniHuman 2.0 把照片生成视频:上传清晰授权人像,写一句动作指令即可出片。适合欢迎语、产品介绍与短讲解;NanoPic 是独立平台,与字节跳动无隶属或背书关系。
打开工具
在线使用 Pika H3 Flex,把一句描述或一张照片变成短视频。支持文生视频和单图首帧图生视频,可选 480p 或 768p,无需安装,在浏览器里直接生成。
打开工具
Hedra Character 3 AI 视频生成器:上传一张角色照片,写下台词和语气,就能生成嘴型、眼神和头部动作都跟着声音走的对口型说话视频。
打开工具