
1. 上传一张你有权使用的人像
挑清晰、光线充足的照片,脸完整可见,嘴巴自然闭合或放松。按发布画幅裁剪:短视频用竖版,课程演示用横版;要手势就选半身照。只上传同意被做成动画的成年人照片,或你拥有版权的角色。名人与未成年人照片不允许。
套餐最高可省 73%
OmniHuman 2.0 是字节跳动推出的音频驱动数字人视频模型:一张人像加一段录音,生成人物开口说话或演唱的视频,口型、表情、转头和手势跟着语气走。它听的不只是音节,还有这句话怎么说——平静讲解更稳,笑声带动眼周,兴奋宣布动作更大。同一张脸可以反复换稿而形象保持一致。在 NanoPic,你可以通过照片生成视频的方式使用 OmniHuman 2.0:上传清晰授权人像,写一句动作指令,生成会动的短片。先选一张清楚的脸,再写清情绪与运镜,适合欢迎语、产品介绍和短讲解。
挑清晰、光线充足的照片,脸完整可见,嘴巴自然闭合或放松。按发布画幅裁剪:短视频用竖版,课程演示用横版;要手势就选半身照。只上传同意被做成动画的成年人照片,或你拥有版权的角色。名人与未成年人照片不允许。
用一两句话描述想要的情绪、手势或运镜,例如「温和微笑,身体微微前倾,镜头缓慢推近」。OmniHuman 2.0 这类流程最怕指令又长又碎,连贯的自然动作比机械清单更稳。
点击生成,从头到尾看一遍,检查开场表情和收尾姿态,满意后下载。若取景偏紧或手势偏重,可改写指令、用同一张人像再生成一次。
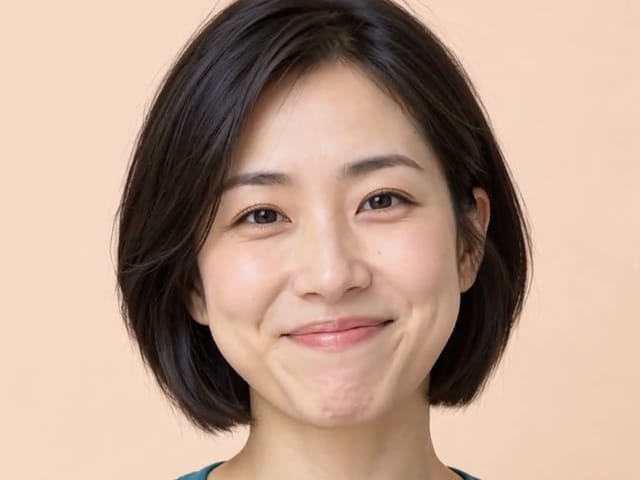
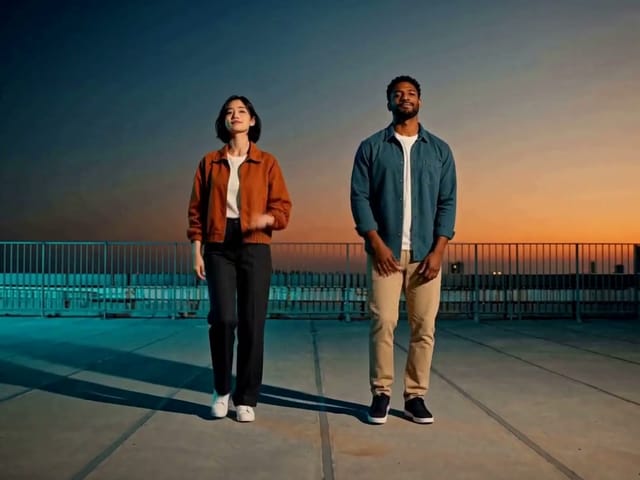
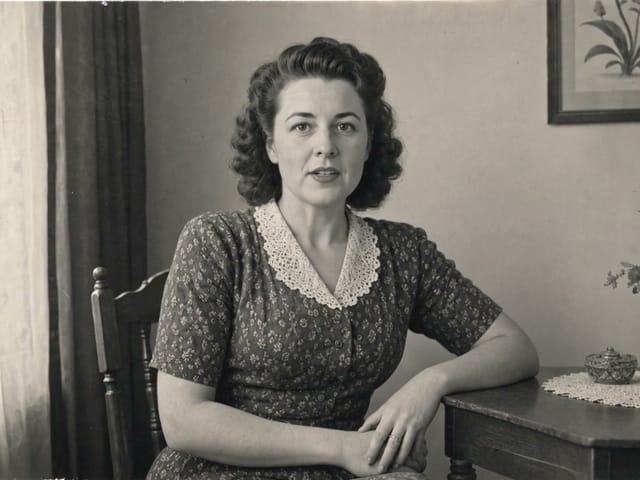
四条路径说明 OmniHuman 2.0 如何把静帧做成图生视频表演。
OmniHuman 2.0 的核心是让静帧成为会动的面孔。在 NanoPic 先上传人像,要求轻轻微笑、点头或微微转头,并检查取景是否稳定。先选一张清楚脸的习惯,适合接到欢迎语、产品介绍和短讲解。
生成人像视频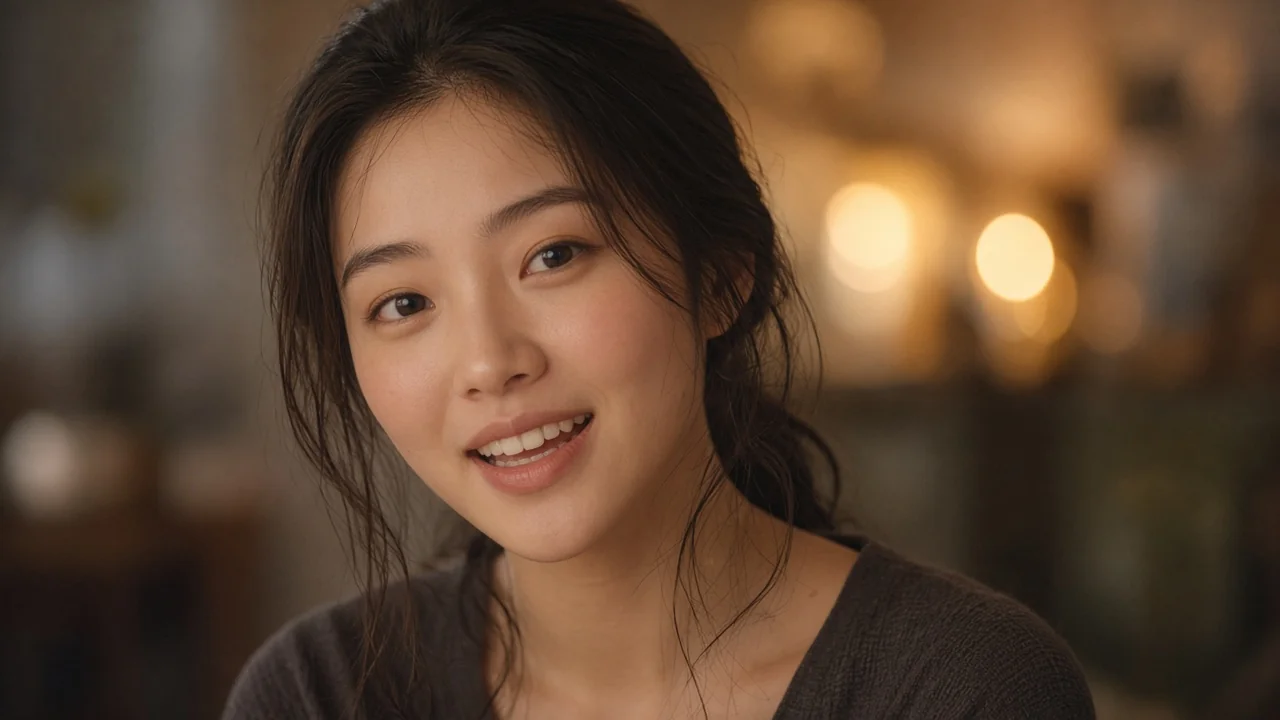
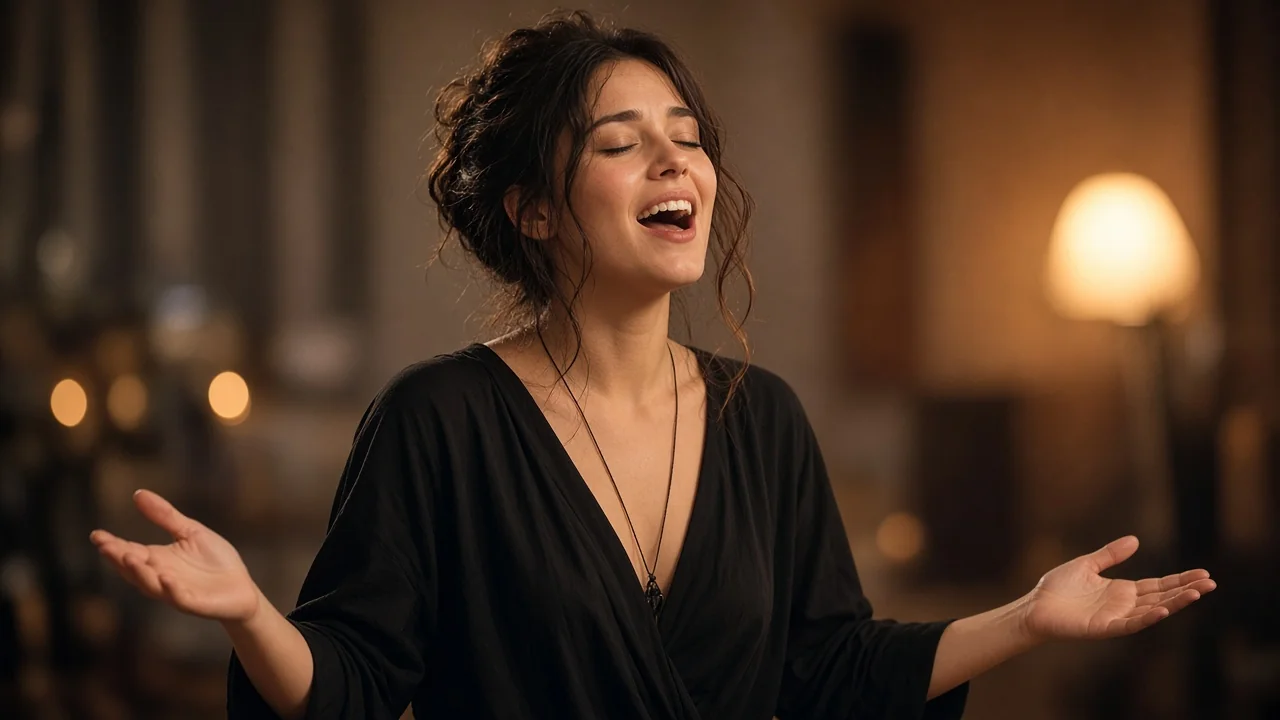
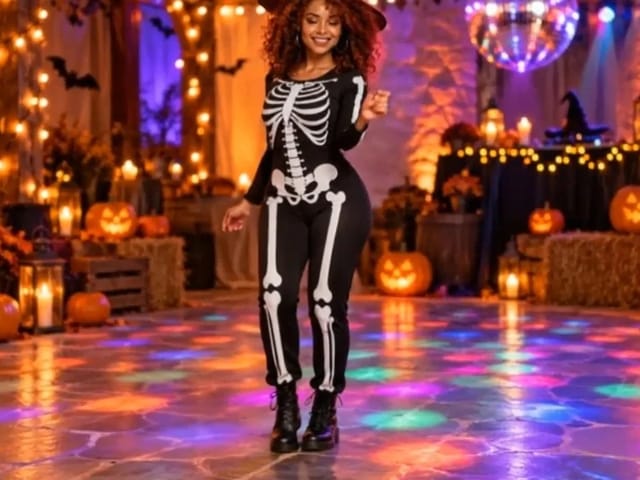
一句文字指令就能引导姿态、情绪和镜头运动,同时让 OmniHuman 2.0 保持主体稳定。讲课可要求手势克制,发布可要求姿态舒展,结尾可配缓慢推近。指令和语气一致时最自然。
指挥镜头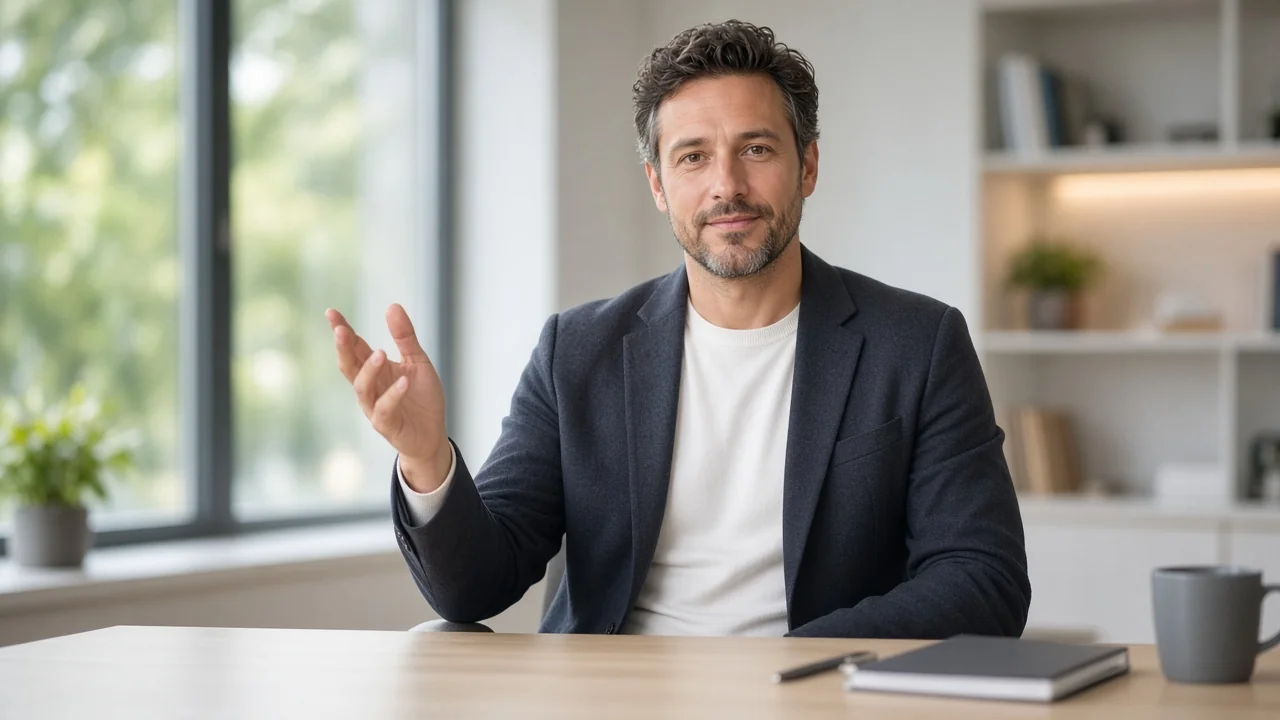
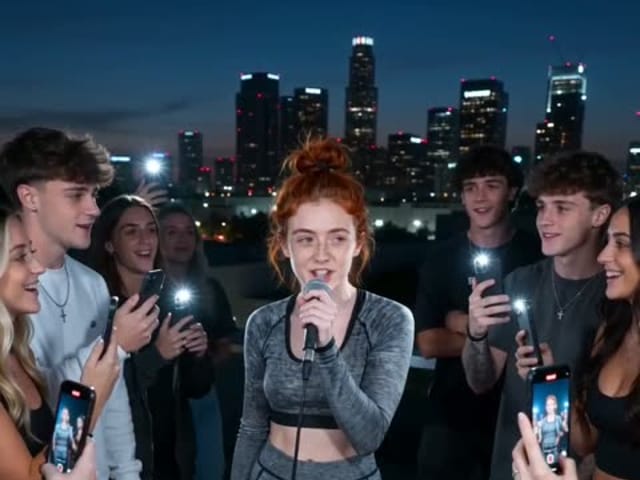
OmniHuman 2.0 可面向多人画面,如两位主持人或一小群朋友。指令里写清谁主导、其他人怎么反应,例如「左边的女士说话,旁边的男士边听边点头」。轮流对话建议每轮单独生成。照片里每个人都必须事先同意。
驱动多人合照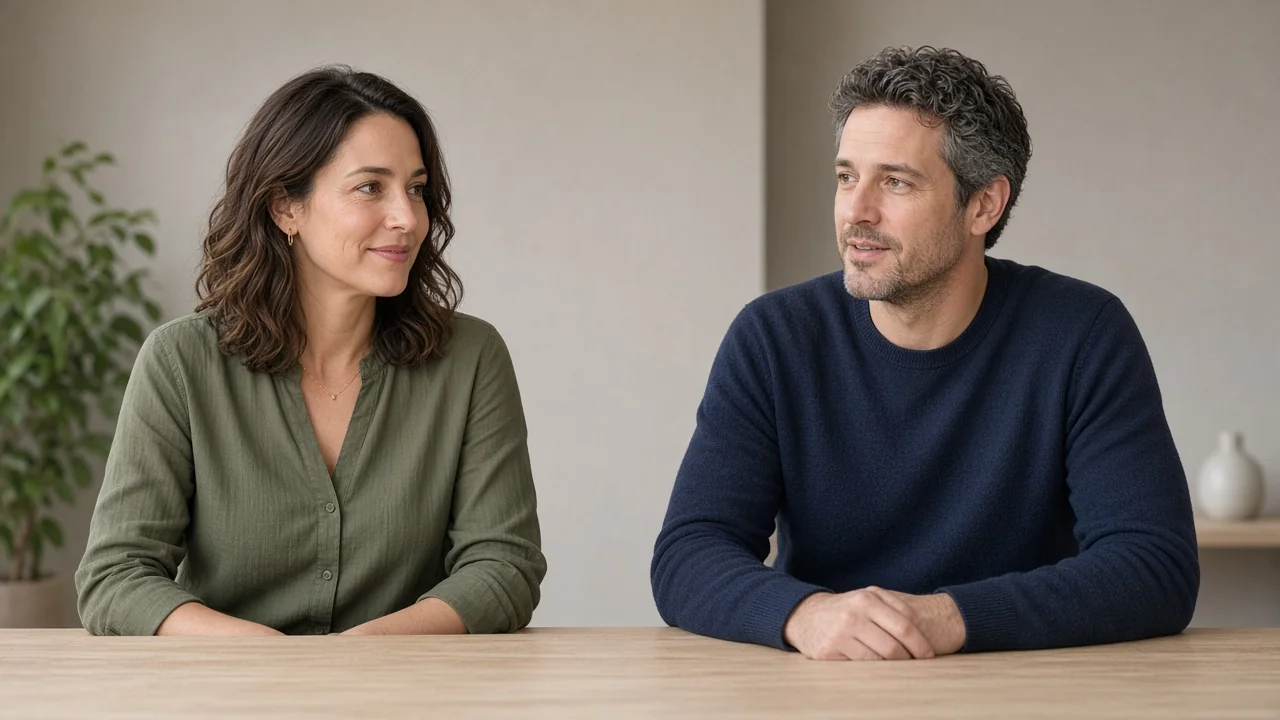
一张清晰的正脸能给 OmniHuman 2.0 最明确的信号。纯色或轻微虚化的背景比热闹的街道、花纹墙面更稳定。
嘴巴闭合、面部放松,OmniHuman 2.0 才有空间做出口型。原图大笑容易和说话动作打架。
指令用一两句话说清情绪、手势和镜头。描述连贯动作,例如举手、微笑再转回镜头。
长稿前先用同一张照片跑一句短指令。取景和手势满意后,再收紧措辞做完整版。
把一张清晰、已获授权的人像当作 OmniHuman 2.0 底图。欢迎语与产品介绍复用同一张脸,形象更一致,也方便只改动作指令。
OmniHuman 2.0 是字节跳动推出的音频驱动数字人模型。它旨在把一张人像和一段人声或歌曲变成人物开口说话或演唱的视频,口型、表情和手势都与声音匹配。
上传一张人像,可选填写一句关于情绪或运镜的指令,然后生成图生视频。看完成片后,若想微笑更轻、手势更稳或推镜更慢,改写指令再生成即可。
一张常见格式的图片,比如 JPG、PNG 或 WebP。选择脸部清晰、裁剪符合发布画幅的照片即可。
OmniHuman 2.0 面向有表现力的口播与唱歌表演。可先用动作指令对准人像的能量与姿态,再检查成片是否读得清。
脸部清晰、正对镜头的插画、三维渲染和风格化角色通常效果不错。动物和抽象画差异更大,建议先用短指令试一次。
可以。OmniHuman 2.0 风格页面支持多人照片。在指令里说明谁主导;轮流对话建议每轮发言单独生成。
必须先取得对方明确同意。只上传你拥有或已获授权的人像与声音。名人、未经同意的公众人物以及未成年人照片都不允许。
每次生成所需的积分会在提交前显示在生成器里。如果生成失败,积分会自动退回。
没有。从 NanoPic 下载的视频不带 NanoPic 水印。
不是。NanoPic 是独立平台,与字节跳动没有隶属或背书关系。
Flux Video Edit 用文字修改已有短视频:上传 MP4,描述颜色、材质或场景变化,在保留原片动作的前提下审片,输出最高 720p。
打开工具
HeyGen Video 1 将文字或一张首帧图片变成带声音的 5–15 秒视频。选择 480p 或 768p,在 NanoPic 制作产品演示、广告短片和图片动画。
打开工具
FastH3 Omni 是开源的有声视频蒸馏模型。浏览器里写提示词、加参考图,即可生成带同步声音的短视频,无需显卡。
打开工具
在线使用 Pika H3 Flex,把一句描述或一张照片变成短视频。支持文生视频和单图首帧图生视频,可选 480p 或 768p,无需安装,在浏览器里直接生成。
打开工具
Vidu Q4 AI 视频生成器:上传 1 张首帧图,写下画面动作、运镜和声音,就能把静态照片变成 3–15 秒、画面与声音一起生成的短视频。
打开工具